
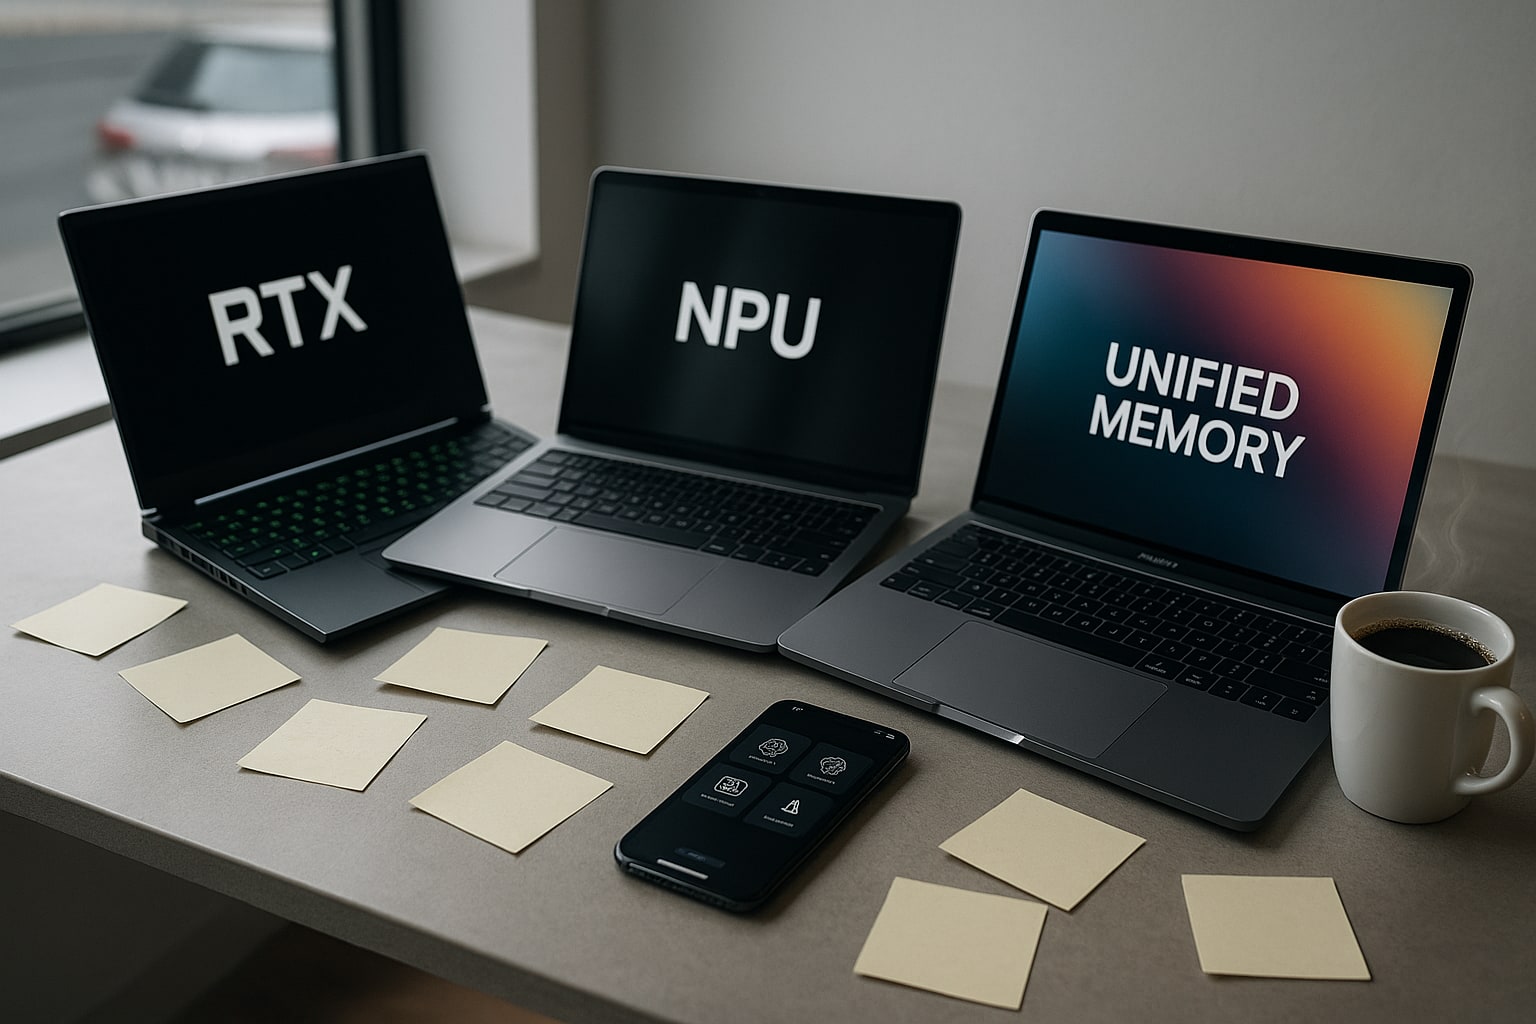
Trabajar con IA "en local" ya no es un capricho de investigador con torre a medida. Cada vez más gente quiere correr un Llama 3 en su portátil sin mandar nada a la nube, generar imágenes con Stable Diffusion sin pagar suscripción, o simplemente probar modelos sin que su empresa se entere. Y ahí empieza la confusión: Microsoft vende los Copilot+ PC como "PCs de IA", NVIDIA insiste en que sin CUDA no hay vida, y Apple presume de memoria unificada. ¿Quién tiene razón? Depende de qué quieras hacer exactamente. Vamos por partes.
Qué significa "IA en local" y por qué el hardware importa tanto
Ejecutar IA en local implica cargar el modelo entero en la memoria del equipo y correr la inferencia con tu propia GPU, NPU o CPU. Nada sale a un servidor. La restricción dura es una: el modelo tiene que caber en memoria rápida, y esa memoria rápida no es tu RAM de sistema — es la VRAM de la GPU o, en Apple Silicon, la memoria unificada.
Un modelo de 7.000 millones de parámetros (7B) en formato FP16 pide unos 14 GB. Cuantizado a 4 bits (Q4), baja a unos 4-5 GB. Un 13B Q4 se mueve entre 7 y 9 GB. Un 70B Q4 pide 40 GB largos. Esa es la aritmética que manda. Todo lo demás — TOPS, benchmarks de marketing, "PC con IA" — es secundario frente a este número.
NPU vs GPU: qué hace cada una y por qué no compiten en la misma liga
Una NPU (Neural Processing Unit) está pensada para tareas de IA de bajo consumo integradas en el sistema: subtítulos en vivo, desenfoque de fondo en videollamadas, Windows Studio Effects, Recall. Los Copilot+ PC actuales rondan los 40-50 TOPS en la NPU. Suena bien, pero esos TOPS están calibrados para modelos pequeños optimizados (normalmente INT8) y no sirven para cargar un LLM grande.
Una GPU dedicada, especialmente NVIDIA con CUDA, juega en otra división. Una RTX 4090 móvil ofrece del orden de 30-40 TFLOPS en FP16 y — más importante — hasta 16 GB de VRAM GDDR6. Para inferencia de LLMs y difusión, la GPU manda. La NPU ayuda en lo cotidiano. No son sustitutos.
Cuánta VRAM necesitas según el modelo que quieras correr
Esta es la tabla que a mi juicio debería ir pegada a la pantalla de cualquiera que se plantee comprar un portátil para IA local:
| Modelo | Cuantización | VRAM mínima | Uso típico |
|---|---|---|---|
| 7B (Llama 3, Mistral) | Q4 | 6 GB | Chat, resúmenes, código básico |
| 13B | Q4 | 10 GB | Razonamiento decente, RAG |
| Stable Diffusion XL | FP16 | 10-12 GB | Generación de imágenes 1024px |
| 34B (Code Llama, Yi) | Q4 | 22 GB | Código serio, contexto largo |
| 70B (Llama 3.1) | Q4 | 40 GB+ | Cercano a GPT-3.5 en calidad |
Si tu techo son modelos 7B-13B cuantizados, una RTX 4060/4070 con 8 GB te vale a duras penas. Si quieres 34B con soltura o SDXL sin sudar, necesitas 16 GB de VRAM. Y para 70B, en portátil, la única vía realista hoy es Apple Silicon con 48-64 GB de memoria unificada.
Cuándo un Copilot+ PC basta (y cuándo no)
Los Copilot+ PC — Surface Laptop 7, Lenovo Yoga Slim 7x, Dell XPS con Snapdragon X — son excelentes para lo que Microsoft diseñó: funciones de IA integradas en Windows, transcripción local, efectos de cámara, ejecución de modelos pequeños tipo Phi-3 Silica optimizados para la NPU Qualcomm Hexagon de 45 TOPS. Para eso funcionan de sobra y con autonomía brutal.
Ahora, ¿ejecutar Llama 3 8B con llama.cpp? Se puede, pero vas a tirar de CPU y unificada compartida, con rendimiento pobre. ¿Stable Diffusion? Olvídate en la práctica: el ecosistema ARM+Windows para IA generativa sigue siendo un páramo. Herramientas clave como ComfyUI o kohya_ss asumen CUDA. Si ese es tu terreno, un Snapdragon X Elite no es tu portátil, por muy bien que rinda en ofimática.
Las tres vías reales para IA local en portátil
Vía 1: portátil gaming con RTX 4080/4090 (16 GB VRAM)
El camino más pragmático si vives en Windows/Linux y quieres compatibilidad total con el stack CUDA — PyTorch, transformers, bitsandbytes, xformers, ComfyUI. El ASUS ROG Zephyrus G16 (2024) con RTX 4090 móvil y 16 GB de VRAM se encuentra desde unos 3.199 €, y es de los más equilibrados en peso (1,85 kg) para lo que ofrece. Alternativas directas: Lenovo Legion Pro 7i Gen 9 (RTX 4090, desde ~3.499 €) y MSI Raider GE78 HX (RTX 4090, desde ~3.699 €), ambos más pesados pero con mejor refrigeración sostenida.
| Modelo | Pantalla | CPU | GPU / VRAM | RAM | SSD | Peso | SO | Precio desde |
|---|---|---|---|---|---|---|---|---|
| ASUS ROG Zephyrus G16 (2024) | 16″ OLED 2.5K 240 Hz | Intel Core Ultra 9 185H | RTX 4090 / 16 GB | 32 GB | 1 TB | 1,85 kg | Windows 11 | 3.199 € |
| Lenovo Legion Pro 7i Gen 9 | 16″ IPS 2.5K 240 Hz | Intel Core i9-14900HX | RTX 4090 / 16 GB | 32 GB | 1 TB | 2,8 kg | Windows 11 | 3.499 € |
| MSI Raider GE78 HX | 17″ IPS 4K 120 Hz | Intel Core i9-14900HX | RTX 4090 / 16 GB | 32 GB | 2 TB | 3,1 kg | Windows 11 | 3.699 € |
Lo mejor: CUDA sin compromisos, 16 GB de VRAM permiten 13B Q4 con contexto largo y SDXL cómodo, ecosistema Linux impecable si prefieres Ubuntu para entrenar.
Lo peor: autonomía real de 3-4 horas con carga ligera y menos de 1 hora con GPU activa, ruido de ventiladores a plena carga cercano a los 50 dB, y esa VRAM de 16 GB se queda corta para 34B sin bajar mucho la cuantización.
Vía 2: MacBook Pro M4 Max con memoria unificada
La jugada de Apple es distinta y, para modelos muy grandes, ahora mismo insuperable en un portátil. El MacBook Pro 16" con M4 Max admite hasta 128 GB de memoria unificada, y esa memoria la ve entera la GPU. Con 48 GB corres un 70B Q4 sin drama. Con 64 GB, con margen. Precio desde 4.229 € en la configuración de 36 GB / 1 TB; la de 48 GB parte de unos 4.729 €. No es barato, pero no hay alternativa Windows equivalente.
El límite: framework fragmentation. MLX de Apple avanza deprisa y llama.cpp con Metal va fino, pero muchos repos de investigación siguen asumiendo CUDA. Para inferencia pura con Ollama, LM Studio o MLX, va perfecto. Para entrenar o hacer fine-tuning con las últimas librerías, hay fricción. Si el salto de chip te interesa, ya analizamos cuándo compensa pasar de M4 a M4 Pro; la lógica se repite hacia arriba con el Max.
| Modelo | Pantalla | Chip | Memoria unificada | SSD | Autonomía | Peso | Precio desde |
|---|---|---|---|---|---|---|---|
| MacBook Pro 16″ M4 Max | 16,2″ Liquid Retina XDR 120 Hz | Apple M4 Max (40 GPU cores) | 36 GB (hasta 128 GB) | 1 TB | Hasta 24 h (según Apple) | 2,14 kg | 4.229 € |
Lo mejor: única forma de correr 70B en portátil hoy, silencio y autonomía impensables en un gaming, construcción y pantalla mini-LED sin rival en la categoría.
Lo peor: precio de la configuración útil (48 GB+) se dispara pasando de 4.700 €, ecosistema CUDA sigue mandando en investigación, y el ancho de banda de memoria, aunque alto, no llega al de una RTX dedicada para inferencia batch.
Vía 3: Copilot+ PC como Surface Laptop 7 o Lenovo Yoga Slim 7x
Para ser justos con la categoría: si tu uso de IA local es Phi-3 Mini, transcripción, subtítulos y funciones integradas de Windows, un Microsoft Surface Laptop 7 (Snapdragon X Elite, desde 1.249 €) o el Lenovo Yoga Slim 7x (desde 1.299 €) hacen el trabajo con 15-18 horas de autonomía y en silencio absoluto. El Dell XPS 14 (2024) con Core Ultra e Intel AI Boost NPU (11 TOPS, por debajo del umbral Copilot+) queda en tierra de nadie: buena máquina, pero ni la NPU llega para funciones Copilot+ ni la GPU integrada para IA seria.
| Modelo | Pantalla | CPU / NPU | RAM | SSD | Autonomía | Peso | Precio desde |
|---|---|---|---|---|---|---|---|
| Microsoft Surface Laptop 7 (13,8″) | 13,8″ IPS 2304×1536 120 Hz | Snapdragon X Elite / 45 TOPS | 16 GB | 256 GB | Hasta 20 h (según Microsoft) | 1,34 kg | 1.249 € |
| Lenovo Yoga Slim 7x | 14,5″ OLED 2.8K 90 Hz | Snapdragon X Elite / 45 TOPS | 16 GB | 512 GB | Hasta 15 h (según Lenovo) | 1,28 kg | 1.299 € |
| Dell XPS 14 (2024) | 14,5″ OLED 3.2K táctil | Core Ultra 7 155H / 11 TOPS + RTX 4050 opc. | 16 GB | 512 GB | Hasta 10 h reales | 1,74 kg | 1.899 € |
Tabla comparativa: puntuación por perfil de uso para IA local
Puntuaciones del 1 al 10 valorando estrictamente el uso para IA local (no rendimiento general).
| Modelo | VRAM/mem útil IA | Compatibilidad frameworks | Rendimiento inferencia | Autonomía | Precio/prestaciones | Total |
|---|---|---|---|---|---|---|
| ASUS ROG Zephyrus G16 (RTX 4090) | 8 | 10 | 9 | 3 | 8 | 7,6 |
| Lenovo Legion Pro 7i Gen 9 | 8 | 10 | 9 | 3 | 7 | 7,4 |
| MSI Raider GE78 HX | 8 | 10 | 10 | 2 | 6 | 7,2 |
| MacBook Pro 16″ M4 Max (48 GB) | 10 | 7 | 8 | 10 | 6 | 8,2 |
| Surface Laptop 7 | 3 | 4 | 4 | 10 | 7 | 5,6 |
| Lenovo Yoga Slim 7x | 3 | 4 | 4 | 9 | 7 | 5,4 |
| Dell XPS 14 (2024) | 4 | 7 | 5 | 5 | 5 | 5,2 |
Veredicto por perfil
- Investigador / desarrollador que hace fine-tuning y usa el stack CUDA: Zephyrus G16 con RTX 4090 o Legion Pro 7i. La RTX manda y punto.
- Usuario que quiere correr modelos grandes (34B-70B) para inferencia sin ruido ni cables: MacBook Pro 16" M4 Max con 48 GB mínimo. No hay alternativa portátil.
- Ofimática pesada con IA integrada de Windows y algún Phi-3 local: Surface Laptop 7 o Yoga Slim 7x. Baratos para lo que ofrecen en autonomía.
- Quien piense "compro un Copilot+ para correr Llama 70B": no. Guarda el dinero o cambia de vía.
FAQ
¿Cuánta VRAM necesito para correr Llama 3 8B en local?
Con cuantización Q4 (la más habitual en Ollama o LM Studio), Llama 3 8B ocupa unos 5-6 GB de VRAM y deja margen para contexto de 4-8k tokens. Con 8 GB de VRAM va justo pero funciona; con 12 GB o más, cómodo y con contextos largos.
¿Un Copilot+ PC con NPU de 45 TOPS puede sustituir a una GPU NVIDIA para IA?
No para IA generativa seria. La NPU está optimizada para modelos pequeños INT8 integrados en Windows (Recall, Studio Effects, Phi-3 Silica). Para LLMs 13B+, Stable Diffusion o fine-tuning necesitas GPU dedicada NVIDIA con CUDA o Apple Silicon con memoria unificada amplia.
¿Merece la pena un MacBook Pro M4 Max frente a un portátil gaming con RTX 4090 para IA local?
Depende del tamaño de modelo. Para 7B-13B, la RTX 4090 rinde más y cuesta menos. Para 34B-70B, el M4 Max con 48-64 GB de memoria unificada es la única opción práctica en portátil, porque una RTX móvil se queda en 16 GB de VRAM.
¿Puedo entrenar modelos desde cero en un portátil?
Entrenar desde cero un LLM útil no es viable en portátil, ni siquiera con RTX 4090. Lo que sí puedes hacer es fine-tuning con LoRA o QLoRA sobre modelos base 7B-13B en una RTX 4080/4090 móvil, o en un MacBook Pro M4 Max usando MLX. Para preentrenamiento real, el sitio es un servidor con varias GPUs de 24-80 GB.

3 comentarios
Pingback: ASUS ProArt P16 vs MSI Creator M16: dos portátiles para creadores con RTX 4070 frente a frente – Análisis de Gadgets
Pingback: Los 5 portátiles para programar por debajo de 1.500 € con al menos 32 GB de RAM – Análisis de Gadgets
Pingback: PS5 Slim vs Xbox Series X: qué consola de 500 € compensa más en 2026 – Análisis de Gadgets