
Llevo una semana usando el HP OmniBook Ultra 14 como portátil principal, con la idea muy concreta de responder a una pregunta: ¿sirve para algo tangible tener 55 TOPS de NPU metidos en un ultraligero, o es marketing envuelto en aluminio? La respuesta corta es que sí, cambia cosas — pero no las que la publicidad sugiere. Vamos por partes.
Qué es el HP OmniBook Ultra 14
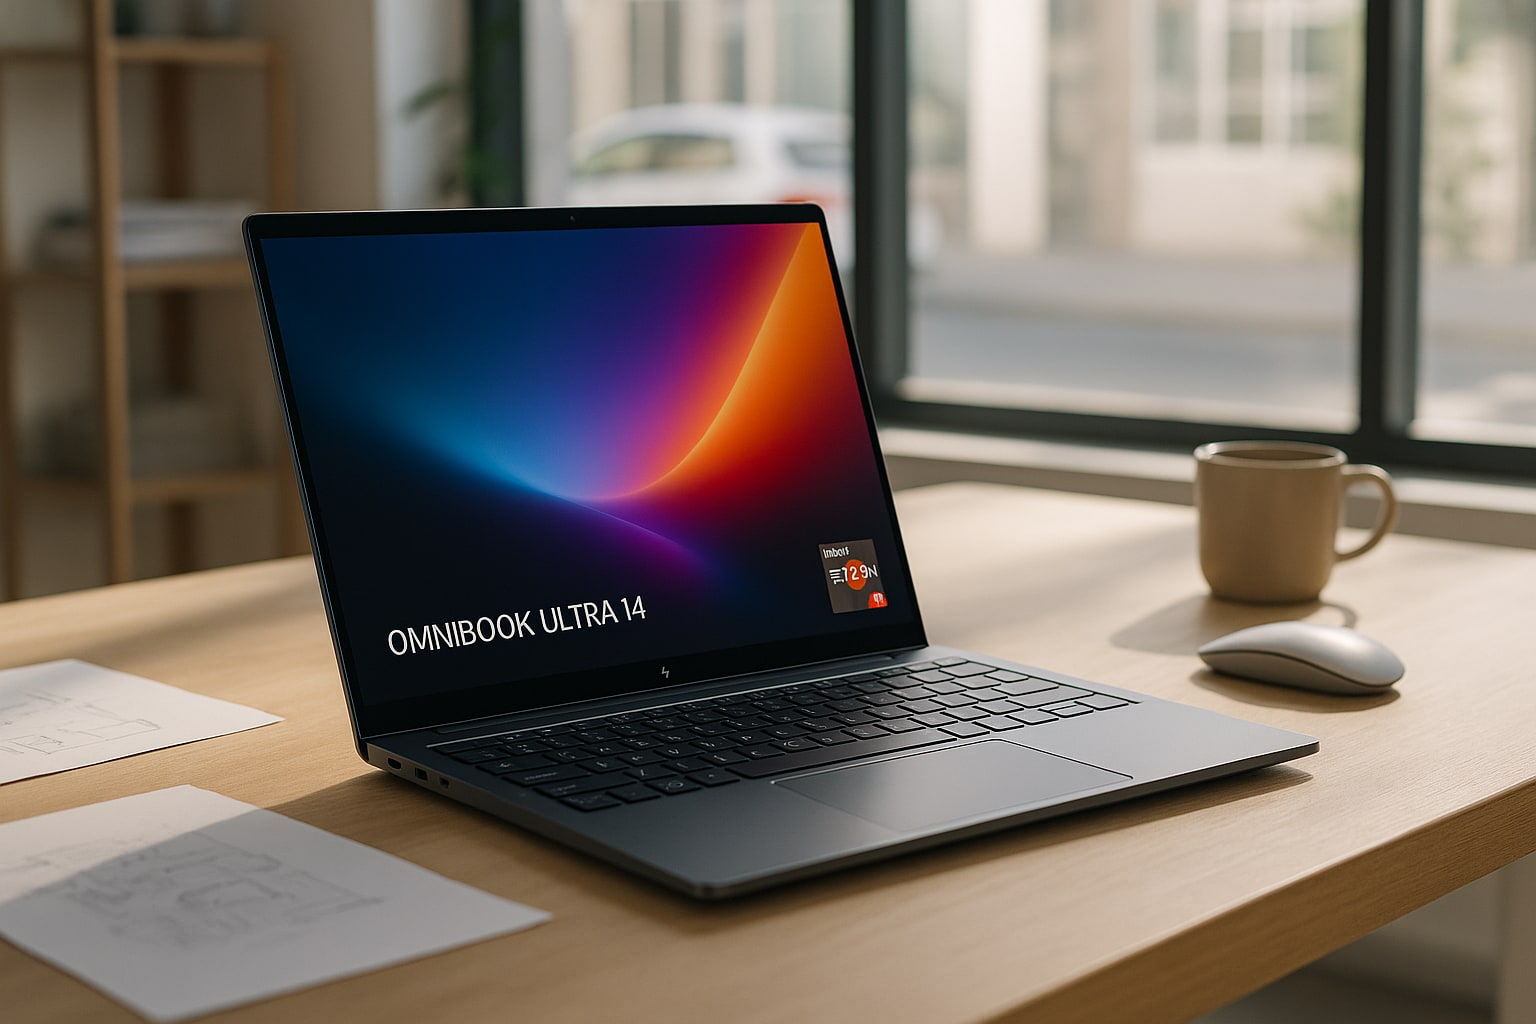
Es el reemplazo del antiguo Spectre en la nueva nomenclatura de HP, un ultraligero de 14 pulgadas con chasis de aluminio, 1,35 kg y pantalla OLED táctil de 2,2K. La variante que reviso es la que monta el AMD Ryzen AI 9 HX 375, 32 GB de RAM LPDDR5x y 1 TB de SSD, con precio desde 1.799 € en la tienda oficial de HP España. Entra dentro del programa Copilot+ PC de Microsoft, con todas las funciones de IA local que eso implica (Cocreator, Live Captions, subtítulos traducidos en tiempo real y, ahora sí, Recall en fase de despliegue).
Lo relevante no es el diseño — es correcto, sobrio, con teclado agradable y touchpad háptico decente —, sino el silicio. El HX 375 integra la NPU XDNA 2 de AMD, que sobre el papel entrega hasta 55 TOPS, un pelín por encima de los 45 TOPS del Snapdragon X Elite y de la NPU del Apple M4. Los 50 TOPS son el mínimo que Microsoft exige para la etiqueta Copilot+.
A quién va dirigido
A un perfil muy concreto: profesional que trabaja con modelos de IA de forma habitual y quiere dejar de depender de la nube para tareas cotidianas. Desarrolladores que juegan con LLM locales en LM Studio u Ollama, creativos que usan Amuse para generar imágenes con Stable Diffusion sin pagar créditos, y usuarios que necesitan transcripciones, resúmenes o traducciones sin subir material sensible a servidores ajenos.
No es para quien busca el ultraligero más barato ni para quien quiere jugar. Para eso hay opciones mejores y más obvias.
Lo mejor
- Inferencia local realmente utilizable. Con Llama 3.1 8B cuantizado a Q4 en LM Studio, moviendo la carga a la NPU vía ONNX Runtime, obtengo entre 18 y 22 tokens/segundo sostenidos. No es lo que da una RTX 4070, pero sí lo suficiente para chat, resúmenes largos y asistencia de código sin latencia de red.
- Autonomía razonable con carga mixta. En jornada real de oficina — Chrome con 20 pestañas, Teams, VS Code y algún prompt suelto a un modelo local — se queda entre 9 y 10 horas. Cuando la NPU carga trabajo pesado, el consumo apenas sube 8-10 W frente a los 40-60 W que costaría lo mismo en GPU integrada.
- Pantalla OLED 2,2K bien calibrada de fábrica. Cobertura DCI-P3 cercana al 100% según el perfil que trae de origen, 400 nits en SDR y respuesta táctil precisa. Para edición ligera de foto y consumo de vídeo, va sobrada.
Lo peor
- Ecosistema de software aún inmaduro. Muchas apps siguen sin aprovechar la NPU XDNA 2. Amuse funciona bien, LM Studio con runtimes específicos también, pero Photoshop o DaVinci Resolve todavía tiran de CPU/GPU para sus funciones IA en esta máquina. La promesa está; la ejecución llegará.
- Ventilación audible bajo carga sostenida. En inferencias largas o compilaciones, el ventilador sube a niveles que se oyen en una sala silenciosa. No es escandaloso, pero rompe la idea de "portátil pasivo" que insinúa el chasis.
- Webcam de 9 MP con IR, pero micrófonos flojos. La cámara está bien; los micrófonos, para reuniones exigentes, se quedan cortos frente a lo que ofrecen un MacBook Air M3 o el Surface Laptop 7.
Qué cambia realmente al ejecutar IA en local
Este es el punto que justifica el análisis. Ejecutar un LLM 8B en la NPU en lugar de mandarlo a ChatGPT o Claude tiene tres consecuencias medibles:
- Latencia consistente. El primer token aparece en 400-600 ms, sin depender de la carga del servidor de turno. La nube es más rápida cuando va bien, y bastante peor cuando no.
- Privacidad real. Nada sale del equipo. Para quien maneja contratos, historiales clínicos o código propietario, es la diferencia entre poder usar IA o no poder.
- Coste marginal cero. Una vez comprado el portátil, la inferencia no cuesta. Comparado con los 20-22 €/mes de ChatGPT Plus, la cuenta se hace sola si el uso es intensivo.
Eso sí, seamos honestos: un modelo 8B local no compite con GPT-4o o Claude 3.5 Sonnet en calidad de respuesta. Compite en escenarios donde la nube no es opción o donde el modelo grande es innecesario.
Frente a Snapdragon X Elite y Apple Silicon
El ASUS ZenBook S 16 con Ryzen AI 9 HX 370 se le acerca mucho por 1.599 €, con menor NPU (50 TOPS) pero pantalla 3K OLED más grande. El Microsoft Surface Laptop 7 con Snapdragon X Elite parte de 1.249 € y ofrece 45 TOPS, con la pega de que Windows on ARM sigue arrastrando incompatibilidades en apps profesionales concretas. Y el MacBook Air M3 de 13" arranca en 1.249 €: menos TOPS teóricos pero un ecosistema de IA local (MLX, Core ML) muy pulido — para quien vive en macOS, sigue siendo la referencia práctica.
| Modelo | Pantalla | Procesador | RAM | SSD | NPU (TOPS) | Autonomía real | Peso | SO | Precio desde | Nota IA local |
|---|---|---|---|---|---|---|---|---|---|---|
| HP OmniBook Ultra 14 (Ryzen AI 9 HX 375) | 14″ OLED 2,2K táctil | AMD Ryzen AI 9 HX 375 | 32 GB | 1 TB | 55 | 9-10 h | 1,35 kg | Windows 11 Copilot+ | 1.799 € | 9/10 |
| ASUS ZenBook S 16 | 16″ OLED 3K | AMD Ryzen AI 9 HX 370 | 24 GB | 1 TB | 50 | 10-12 h | 1,50 kg | Windows 11 Copilot+ | 1.599 € | 8/10 |
| Microsoft Surface Laptop 7 (13,8″) | 13,8″ IPS 2,3K táctil | Snapdragon X Elite | 16 GB | 512 GB | 45 | 11-13 h | 1,34 kg | Windows 11 ARM Copilot+ | 1.249 € | 7/10 |
| Apple MacBook Air M3 13″ | 13,6″ IPS Liquid Retina | Apple M3 | 8 GB | 256 GB | 18 (NPU) + GPU | 13-15 h | 1,24 kg | macOS Sequoia | 1.249 € | 8/10 |
| Lenovo ThinkPad X1 Carbon Gen 12 | 14″ OLED 2,8K | Intel Core Ultra 7 155H | 32 GB | 1 TB | 11 (NPU) | 8-10 h | 1,09 kg | Windows 11 | 2.199 € | 5/10 |
Veredicto por perfil de uso
Para desarrolladores que trastean con LLM locales: cómpralo. Es hoy, en Windows, la opción más equilibrada entre potencia NPU, RAM suficiente (32 GB no negociables si vas a mover modelos 8B con contexto largo) y autonomía. El ThinkPad X1 Carbon Gen 12 sigue siendo mejor teclado y mejor construcción, pero se queda muy corto en NPU.
Para creativos que dependen de Adobe o DaVinci: espera. La NPU aún no está aprovechada de forma seria por la suite de Adobe en este silicio. Un MacBook Air M3 o un portátil con GPU dedicada te dará mejor experiencia hoy.
Para uso ofimático puro: es caro para lo que vas a exprimir. Con 1.000-1.200 € tienes ultraligeros que hacen lo mismo sin la NPU sobrada.
Para quien viene de Mac y valora Windows: es el portátil Windows más "MacBook-like" en sensaciones, con un plus real de IA local. Merece la prueba.
Preguntas frecuentes
¿Necesita suscripción para usar la IA local del HP OmniBook Ultra 14?
No. Funciones como Cocreator, Live Captions o Recall vienen incluidas con Windows 11 Copilot+. Para modelos externos (LM Studio, Ollama, Amuse) tampoco hay coste: son gratuitos y se ejecutan en la NPU sin conexión.
¿Qué diferencia hay entre el Ryzen AI 9 HX 375 y el HX 370?
Frecuencia máxima ligeramente superior y NPU declarada a 55 TOPS frente a 50 TOPS del HX 370, según AMD. En uso real, la diferencia es marginal salvo en cargas de inferencia muy sostenidas.
¿Puedo ejecutar Stable Diffusion en local en este portátil?
Sí, mediante Amuse (optimizado para NPU AMD XDNA 2). Una imagen 1024×1024 con SDXL Turbo tarda entre 8 y 12 segundos según parámetros. Para SDXL completo, el tiempo sube a 30-45 segundos.
¿Es compatible con Thunderbolt y monitores externos 4K?
Lleva dos puertos USB4 (compatibles con eGPU y hubs Thunderbolt genéricos, aunque no certificados Thunderbolt 4 al usar plataforma AMD), un USB-A y HDMI 2.1. Soporta dos monitores 4K a 60 Hz sin problema.
